
前传 · Netscape 之死
2000 年 4 月 6 日,Joel Spolsky 在他的博客上发了一篇文章。事情要从 Netscape 说起:1998 年初,Netscape 决定把 Navigator 推倒重来——旧代码太乱,工程师们觉得没救了,不如从零开始。这一重写就是将近三年。三年里,随 Windows 免费捆绑的 Internet Explorer 把市场一寸一寸吃了下来;等 Netscape 6 终于在 2000 年底磕磕绊绊地放出来,他们才发现第一次浏览器大战都打完了,连战场都没了。
而 Netscape 自己,在这三年里已经先把自己卖给了 AOL。Netscape 6 又慢 bug 又多,剩下的用户跑得比谁都快;2003 年,AOL 解散了整个浏览器团队;2008 年 3 月 1 日,最后一个版本停止支持,曾经的市场霸主——十年前,它还是浏览器的代名词——就这样消失了。
Spolsky 把这个决定称作「一家软件公司能犯的最糟糕的战略错误」,然后写下了那句后来被引用了二十六年的话:
When you throw away code and start from scratch, you are throwing away all that knowledge.
翻成人话就是:不要轻易从头重写,因为你扔掉的不只是代码,而是多年积累在代码里的 knowledge。
他还顺手解释了程序员为什么总是想重写:「读代码比写代码难。」他举的例子是一个两页长的函数,功能不过是弹出一个窗口,却打满了莫名其妙的「补丁」:这里多一个判断,那里绕一段特殊处理,还有一个丑得要命的 LoadLibrary 调用,谁也说不清它们为什么在那儿。
Spolsky 说,这些补丁没有一块是多余的,每一块背后都是一次真实的事故:某台电脑没装 Internet Explorer,软件装不上,于是多了一个判断;程序在内存不够时会崩,于是多了一段处理;用户在读写中途把软盘拔了出来,于是又多了一段;至于那个丑陋的 LoadLibrary,是为了让程序在老版本的 Windows 95 上也能跑。把任何一块揭掉,某个角落里的某个用户就会再摔一次。
二十六年过去了,软盘没了,Windows 95 没了,Netscape 也没了。那句话还在。而且 2026 年,它遇到了二十六年来最硬的对手。
一、旧代码里到底藏着什么
这个思想最容易被误读成:
旧代码就是好代码,所以不能改。
完全不是。Spolsky 从头到尾没有说旧代码好——他说的是旧代码里藏着东西。至于藏着什么,我觉得至少可以分成四层。
第一层:显性的业务规则
if customer.country == "US":
    ...
这一层最简单,人一眼能看懂,AI 也一眼能看懂。它就是产品文档里写着的那些规则,只不过换了个地方存放。
第二层:历史 bug 的 knowledge
if amount == 0 and payment_provider == "XYZ":
    retry_after = 2
一个新来的程序员大概率会说:金额为 0 为什么要特殊处理?删掉。
但它可能是因为 2017 年 XYZ 这家支付网关有一个古怪的 race condition,零金额的请求偶尔会被卡住,等两秒再试就好了。这行代码其实是在说:「我们已经踩过这个坑了。」踩坑的人可能早就离职了,坑还在,只剩这两行代码替他站岗。
第三层:兼容性 knowledge
更危险的是这一层:
- 某个浏览器的某个版本
- 某个老版本的数据库
- 某个客户自己魔改过的 API
- 某个地区不一样的日期格式
- 某个把标准实现错了的硬件设备
- 某个第三方 API,实际行为和它的文档根本不是一回事
这些兼容性细节往往没有完整写进规格说明,却已经体现在代码里。 它们就藏在 if、else、workaround、retry、fallback 和 compatibility shim 里。Spolsky 说的那些「补丁」,绝大部分打在这一层。
第四层:根本不在代码里的知识
这才是 AI 时代最大的坑。一个跑了很多年的系统,它真正的 specification 是下面这些东西的总和:
代码
+ 测试
+ Git 历史
+ 问题跟踪记录
+ 生产日志
+ 客户投诉
+ 数据库里的脏数据
+ 某个员工脑子里的经验
源代码只是其中一项。所以,即使你今天把整个 repo 喂给一个 coding agent,也不意味着它拿到了这个系统的完整知识——它拿到的是前三层,外加第四层里碰巧被写进注释和测试的那一小部分。
二、二十六年后的对手
写到这里,一个自然的问题是:模型到底强到了什么程度,敢去碰 Spolsky 划的这条线?
答案就在这几天。9 月 1 日,Anthropic 发布了 Claude Fable 5.1;9 月 3 日,OpenAI 发布了 GPT-6 Astra。两场发布会没有一场在聊「聊天」,全在讲 agentic coding:把任务交给模型,让它自己在终端里跑到底。数字摆在一起:
| 基准 | Fable 5.1 | GPT-6 Astra | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 55.8% | 57.7% | 42.0% | 37.3% |
| Terminal-Bench-Science 0.1 | 52.6% | — | 24.7% | 22.4% |
| DeepSWE v1.1 | 67.4% | 74.1% | — | 72.7% |
| FrontierCode 1.1 Extended | 64.9% | 64.5% | — | — |
| Humanity's Last Exam(带工具) | 65.0% | 57.2% | 63.8% | — |
Fable 5.1 和 Astra 到底谁更强,我觉得意义不大:现在每家模型公司都在有意或者无意地做 benchmark cheating,公布出来的又都是对自己有利的项目,benchmark 本身已经越来越说明不了什么了;而且 benchmark 和真实使用体验之间的差距,已经大到哪天可以单独拿出来写一篇 blog 了。
所以这张表最多只算半个答案。基准是有人出题、有人写答案的考试;重写一个跑了二十年的系统,没人写过答案。另一半答案,在过去四个月里这几件真事里——而且它们全都发生在这两个模型发布之前:
| 案例 | 迁移 | 规模 | 耗时 | 验证方式 |
|---|---|---|---|---|
| Bun / Anthropic | Zig → Rust | 535,496 行 Zig | 11 天,最高 64 个 Claude Agents 并行 | merge 前全套 CI 100% 通过;上线后发现 19 个回归并修复;Bun 1.4 已正式发布 |
| TensorFlow → JAX | YouTube 的真实模型:数千行、数百个 layer | 数月 → 几周,比人工快 6.4–8 倍 | 静态分析 + 用梯度上升找新旧 layer 之间的最大误差 | |
| Wiz | Python → Go(pypdf) | 约 5 万行 → 18,413 行 | 约 20 小时 | 500 个疑难杂症 PDF + 生产环境 feature flag 与旧实现逐个比对 |
| Anthropic Labs | Python → TypeScript | 16.5 万行 TypeScript | 一个周末 | 数百个 agent、8 道 phase gate、3 轮 adversarial review,每条命令的输出与 Python 原版 diff |
三、Bun:11 天,53 万行代码和 16.5 万美元
Bun 的情况比「Claude 帮我重构了几万行」激进得多。
Jarred Sumner 手上原来是 535,496 行 Zig(不含注释)。他自己的估算是:一个非常熟悉整个 codebase 的小团队,大概要一年。
实际做法是:一个主要负责人,加上一个当时还没公开发布的 Claude 模型,加上 Claude Code 的 dynamic workflows。5 月 3 日开工,5 月 14 日收工,11 天。
细节都写在 Bun 官方的复盘里:
- 动手之前,Sumner 先花了大约 3 个小时和 Claude 讨论 Zig 的各种模式该怎么映射到 Rust,Claude 把讨论整理成一份
PORTING.md;又跑了一遍全 codebase 的 lifetime 分析。先拿 3 个文件试了一轮,才放开跑。 - 每个任务的结构是固定的:一个 implementer,两个以上 adversarial reviewer,一个 fixer。大约 50 个 dynamic workflow,4 个 worktree 并行,最多的时候 64 个 Claude 实例同时在跑;总共 6,502 个 commit,最快的时候一分钟 1,300 行。
- 硬性要求是 Bun 现有的测试套件在所有平台上都要 100% 通过——大约 6 万个测试文件、130 多万个
expect(),跳过和删除的测试数量是 0。
Anthropic 后来在一篇博客里披露了账单:5.9B uncached input tokens、690M output tokens,另有 72B 的 cached input reads;按 API 公开价格算,大约 165,000 美元。合并之后,生产环境里陆续发现了 19 个已知的回归,Anthropic 说已经全部修掉。
而且最终不是一个 prototype。8 月 20 日,Bun 1.4 正式发布,这是第一个完全跑在 Rust 上的稳定版;1.3.14 成了最后一个 Zig 版本。
这意味着以前那个经济模型:
3 个工程师 × 1 年
突然可以大致变成:
1 个专家 + 11 天 + $165k 推理成本 + CI / 模糊测试 / 代码审查
这已经不是 20% 的 productivity improvement,这是一个数量级的变化。
当然,也不是所有人都买账。Zig 的作者 Andrew Kelley 把这次重写称作「unreviewed slop」,他的质问其实很准确:一套为 Zig 写的测试,凭什么足以验证一百万行没人读过的 Rust?这个问题我先不回答。读到后面你会发现,它和 Spolsky 的问题是同一个问题。
四、Wiz:99% 和 1%
Wiz 想把 pypdf 搬到 Go。
这是一个几乎逐条命中 Spolsky「危险条件」的项目:Python;超过 20 年的历史;大约 5 万行;PDF 本身是一个塞满了诡异历史兼容性的格式;全世界每一个生成 PDF 的软件,都有自己对标准的一套理解。而 pypdf 这二十年干的事,就是把这些怪癖一个一个学会。
理论上,这就是那种「千万别 rewrite,里面全是 20 年攒下来的 hidden knowledge」的项目。
结果 Claude 真干了。Wiz 的案例里,工程师们用了大约 20 小时——10 小时开发,10 小时测试——把 5 万行 Python 变成了 18,413 行 Go。他们专门收集了 500 个疑难杂症 PDF 做测试集,全部通过。
看起来 Spolsky 的教条现在已经不成立了?
不。
他们把新库放进生产,用 feature flag 和旧的 Python 实现并排跑,逐个比对输出:99% 的结果一致。
很好。可是还有 1%。
而这最后的 1%,只在真实的客户数据里出现——精心挑选的 500 个疑难杂症样本,没有一个覆盖到它们。Wiz 又根据生产环境里的真实输入做了多轮诊断(每个出问题的文件要来回 5 到 10 轮),最后找出并修掉了 20 到 30 类不同的问题。
这正是 Spolsky 那句话的 2026 年版本:
2000 年:你的旧代码上打满了补丁,每一块都是一个修掉的 bug,你不知道它们补的是什么,但你不能揭。
2026 年:Claude 20 小时移植了一个 20 年历史的 PDF parser,500 个疑难杂症测试全过,但生产环境里仍然藏着最后那 1%——那些补丁,AI 能从旧代码里读出来的,都搬过去了;没写进代码的,还得靠客户一块一块撞出来。
所以 AI 并没有消灭 unknown unknowns。它只是把「重新发现这些 unknowns」的速度,提高了很多。
五、我自己的版本:Web Update Monitor
在说结论之前,插一个我自己的例子。
Web Update Monitor 最开始在我眼里只是个小程序,就直接用 JavaScript 写了(它到现在还没对公众开放,因为我一直懒得把它从单租户单用户系统改成多租户多用户系统——我都能想象出要写多少测试、会遇上多少边缘 bug)。写到两万行的时候,撞上了一个 JavaScript 自己查不出来的 bug——一个字段在某条路径上是 undefined,一路传到很深的地方才炸,翻了半天才找到源头。我下决心把它迁到 TypeScript。这一步非常顺利——现在回头看,原因很简单:编译器就是裁判。旧代码摆在那里,每一处类型对不上,tsc 都会指着鼻子告诉你,AI 只要顺着报错一个一个改就行。
后来各个组件越长越大,状态散在各处,一个 DOM 改动要手动同步好几个地方,改一处漏一处,我觉得原生 TypeScript 已经不够用了,决定来一次大爆炸式的迁徙:整个搬到 React + Vite。Martin Fowler 有一句被引了无数遍的话,几乎就是专门骂这种做法的:
If you do a big-bang rewrite, the only thing you're guaranteed of is a big bang.
这一次没有东西可以对照。旧程序的行为散落在 DOM 操作和我自己的脑子里,没有测试集,也没有任何东西能告诉 AI「新的这份和旧的那份到底哪里不一样」。结果是烧掉了好几个 Claude Max 的 5 小时额度之后,效果一塌糊涂,只能全部 discard。
但是痛点还在,纠结了一段时间后,又进行了第二次尝试:GPT-5.5 Thinking(因为它的指令遵从比 Opus 4.8 好不少),加上 Goal 模式,再加上最重要的一样——用 Playwright 当眼睛,让它自己打开页面、点按钮、看结果,而不是靠我描述「应该长什么样」;prompt 也写得比第一次复杂得多。这才总算迁了过去。
不过,迁过去之后的 30 多个 PR,几乎全是在解决迁徙带来的问题。
三次迁徙,同一个 codebase,结果完全不同。区别不在模型,而在有没有东西可以对照:第一次有编译器,第三次有 Playwright,第二次什么都没有。至于那 30 多个 PR——那就是我的 1%。
六、变了的和没变的
这些案例摆在一起,结论好像很明显:重写不再是禁忌。但请注意 Bun、Wiz、Google 这三个最成功的案例共同拥有的东西:
               旧实现
                 ↓
           参照 / 标准答案
                 ↓
     ┌───────────┼───────────┐
     ↓           ↓           ↓
    测试       编译器   生产环境追踪记录
     ↓           ↓           ↓
              AI 翻译
                 ↓
              目标系统
                 ↓
              差异检查
也就是说,它们不是:
旧代码 → 删除 → AI 根据 README 猜一个新的
而是:
旧代码 → 变成规格说明 → 让 AI 不断逼近它
最极端的做法是 Anthropic Labs 那个周末:数百个 agent 把一个 Python 工具迁成 16.5 万行 TypeScript 之后,最后一道关卡是把每一条命令的输出和 Python 原版做 diff——不是「tests 看起来差不多」,而是对每一个输入 x 都要求:
Output_Python(x) ==? Output_TypeScript(x)
这叫 differential testing。旧实现不是被删掉的东西,它是标准答案。
Anthropic 自己总结 AI 特别适合做 migration 的原因,其中两条恰好就是:旧代码本身就是一份极好的 spec;以及,自带一个 referee——编译器和测试套件会告诉你哪里错了。这几乎就是 Spolsky 的 insight 被重新包装成了 agentic engineering。
其实在 agentic engineering 之前,这个做法就有过一个名字。2004 年,写过《重构》的 Martin Fowler 在自己的博客上发了一篇 Strangler Fig Application,名字来自一种植物:绞杀榕(图 1)。它的种子由鸟带到大树的高处,落在枝干上发芽,先顺着树干往下扎根;根扎进土里之后越长越粗,一圈一圈把树干包住。被包住的树晒不到光、长不了粗,几年之后死了、烂了,站在原地的只剩一棵中空的榕树——它从来没有砍过那棵树,只是从树身上长了出来。
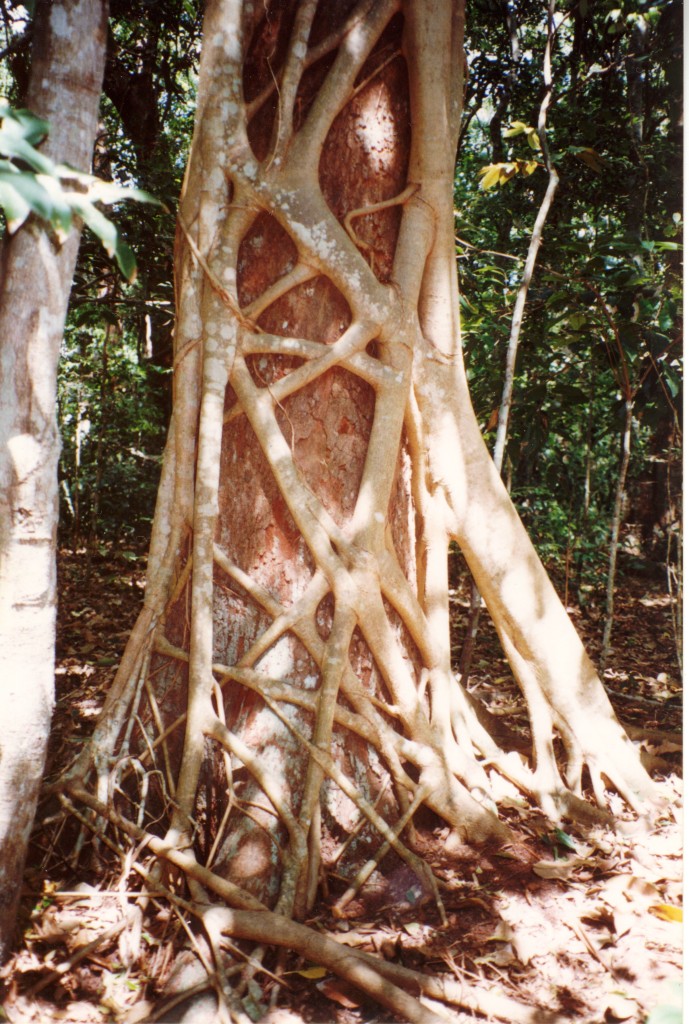

回到软件:那棵被包住的树,是跑了很多年、长满补丁的旧代码;绞杀榕,是新写的那份。它不是一次性把旧代码全部删掉、换上新代码,而是从旧代码身上长出来:先在旧代码前面加一层薄薄的入口,所有请求照旧先到这里;然后挑一个功能,在新代码里重写,把这一个功能的流量切过去,旧代码里对应的那部分就停掉——其余功能还是走旧代码。就这样一项一项挪,每挪一项都可以上线、可以回退,旧代码始终在旁边跑着,随时可以拿来对照。等最后一项也切过去,删掉旧代码,站在原地的,就只剩新的那份。
他的出发点是自己职业生涯里做过太多关键项目的重写:每一次看起来都是「旧的做什么,新的照做就行」,每一次实际都比想象复杂得多,而最危险的是那个 cut-over date——所有东西在某一天一起切过去。所以他的办法就是绞杀榕那一套,别等新的那份全部写好再一次切过去,宁可接受一段时间的过渡架构,换更早拿到的价值和低得多的风险。
两种做法画出来是这样:
而且第二种方式没有一个「全公司的命运都押在星期六晚上」的时刻。绞杀榕之所以安全,正是因为旧代码一直活着——它既是 specification,也是标准答案。Wiz 用 feature flag 让新旧两个实现并排跑,就是这个做法。
回到第一节那四层。前三层 knowledge 都在代码里,AI 读得到;只要旧代码留在验证环节里当 oracle,differential check 就能把它们一层一层逼出来——这正是 Bun 能在 merge 前拿到 100% 的原因。第四层不在代码里,AI 读不到,测试也测不到,它只能在生产环境里被客户撞出来——这正是 Bun 上线后那 19 个回归、Wiz 那 1% 的来历。Andrew Kelley 的质问,说穿了也是在问这一层:测试只能验证它见过的世界。所以那套为 Zig 写的测试,够验证前三层,验证不了第四层——他问得对,只是他问的其实就是 Spolsky 的问题。
所以,那句「千万别从头重写」,到了 2026 年大概该改写成:
重写可以,但别一次切过去。旧代码不能扔——它得留下来,当标准答案。
七、尾声
Netscape 重写了三年,等它写完,市场已经没了。Bun 重写了 11 天,等它写完,Bun 1.4 照常发布。二十六年前的「最糟糕的战略错误」,落到现在,是一张 16.5 万美元的账单。
但有一样东西没变:那 1%。它从来不在代码里,也从来不在测试里;2000 年它藏在某台没装 IE 的电脑里,2026 年它藏在某个客户上传的、谁也没见过的 PDF 里。AI 可以在 11 天内把 53 万行连着补丁一起搬过去,但它搬不动的,是那些从来没被写下来的东西。也正因为这样,我一直坚信:现在高质量的测试集比代码本身值钱。每一条测试背后都是一个真实踩过的坑——竞态也好,边缘情况也好——这些坑是现阶段的 AI 没法一键生成的;但只要有了这样一套测试,用 AI 加上新架构或新语言重写出来的同一个软件,大概率会比原版好得多。
Spolsky 那篇文章的标题是《Things You Should Never Do》。二十六年后,那件禁忌之事,AI 一天要做几十遍。
对写代码的人来说,这大概是最好的时代:任何看不顺眼的东西,都可以推倒重来。也是最坏的时代:推倒得越快,你越来不及知道,自己扔掉的到底是什么。